Jev:一个只做"判断"的模型 | 一方天地
大模型时代,谁来只做"判断"这道题?
心理学家卡尼曼在《思考,快与慢》中提出,人脑有两套思考系统。看到"2+2"你脱口而出 4,走路时下意识避开障碍物,这是快思考——直觉的、不假思索的、几乎不耗费心力;而计算"17×24"你得停下来认真演算,搬家前要反复规划路线,这是慢思考——专注的、经过推敲的、耗时也耗力。
今天的大语言模型几乎都是"慢思考"型的:哪怕只是判断一条工单该分给哪个团队,它也要逐字逐句生成一大段推理过程。但真实软件系统里有海量环节根本不需要深思,只需要一个下意识的判断——这条工单该分给谁?这条内容违规吗?检索回来的这段文字和问题相关吗?
用慢思考模型做这些事,就像开着跑车去楼下取快递:能做,但又贵又慢,输出还得费力解析。最近我体验了一个思路完全不同的模型:Jev——TypeSafe AI 出品的"System One"评估模型,名字正是取自"快思考"。它不生成内容,只做结构化判断,主打两个词:快、便宜。
快到什么程度?实测服务端处理一次调用 99~144 毫秒。便宜到什么程度?一次调用约 0.000012 美元——按定价(输入 $0.042 / 百万 token,输出免费)算,跑一万次也就几美分。
它的调用方式也很特别:不给提示词让它自由发挥,而是给它一份状态(state)和一组类型化问题(questions),它返回结构化答案、每个选项的概率,以及一个关键的元数据——置信度(confidence)。
Jev 的问题类型只有三种,正好对应"判断"的三种基本形态。
能力一:Noul —— 是非判断
Noul 回答"是/否"问题,返回"答案为是"的概率。一次调用可以同时问多个问题。
一个真实例子——判断客户是否在要求退款:
{
  "state": "I was charged twice for my subscription.",
  "questions": {
    "refund": {
      "type": "boolean",
      "instructions": "Is the customer asking for money back?"
    }
  }
}
返回 probability: 0.77,即 Jev 认为 77% 可能是在要求退款。代码里按 0.5 分界即可得到一个布尔结论。适合内容审核、意图预判、guardrail 拦截这类"是/否"闸门。
能力二:Choice —— 从候选中选一个
Choice 给它一组候选选项和每个选项的判定标准(criteria),它选出一个归属,并给出每个选项的概率和置信度。这是工单路由、意图分类的核心能力。
我用中文电商客服场景实测了三个案例:
| 客户留言 | Jev 的选择 | 置信度 |
|---|---|---|
| 耳机到货就坏,要求退款 | 退款退货 | 1.00 |
| 显示签收但没收到货(仍想要商品) | 物流问题 | 1.00 |
| "你们这个订单到底怎么回事,有人管吗?" | 投诉 | 0.76 |
前两个案例一目了然,包括"提到退款字眼但真实诉求是找包裹"这种干扰项也判断正确。第三个案例最有意思:这句话既可以读成投诉(要说法),也可以读成意图不明(转人工分拣),Jev 给了投诉 0.80 的概率,但置信度只有 0.76。
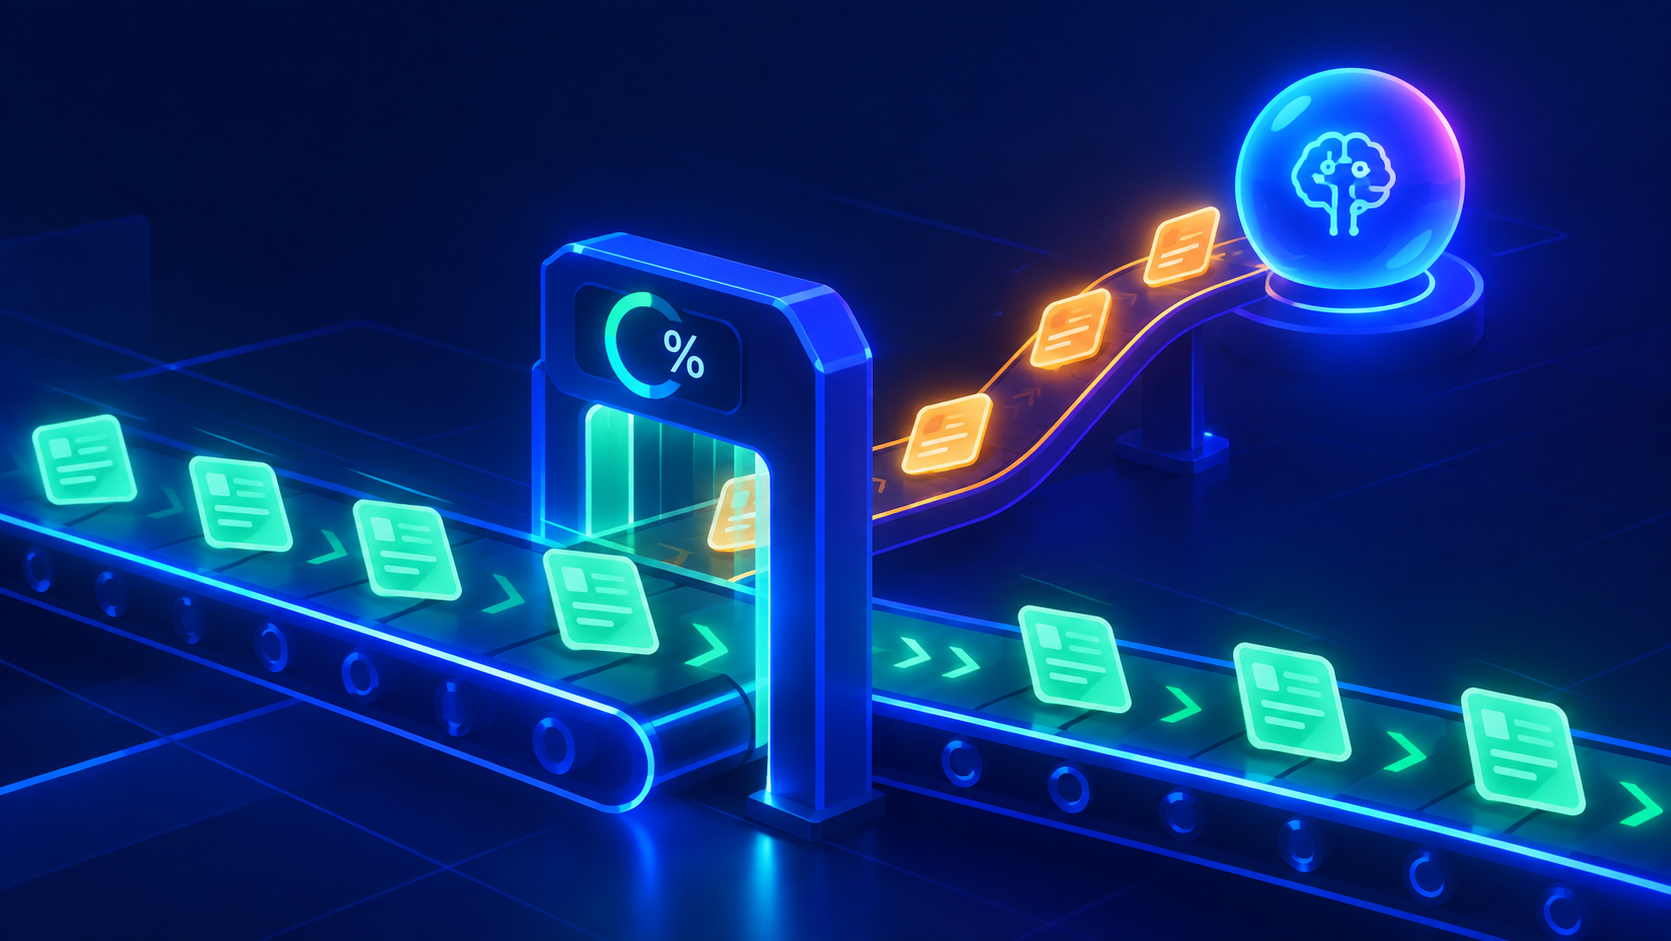
这里引出了 Jev 最重要的设计:置信度 ≠ 概率。概率回答"我选了什么",置信度回答"你要不要信我这次的选择"。工程上的标准用法是置信度门控:置信度 ≥ 0.95 直接采纳;低于阈值,就把同一道题升级给更强的通用大模型独立复核——便宜模型承接 95% 的明显情况,模糊样本自动升级,成本和准确率兼得。
能力三:Score —— 按等级评估打分
Score 让模型把内容放到一把"有序的尺子"上。你定义若干等级,每个等级写一段具体情形描述(官方特别强调:要写"难以下咽:食材不新鲜",而不是"较差"这种程度词,因为模型是靠文本逐条匹配的),它返回 0 到 N-1 的连续分值、每个等级的概率和置信度。
官方推荐的玩法是组合评分(composite scoring):把一个复杂判断拆成多个维度,一次调用并行评估,然后权重放在你自己的代码里合成。比如餐厅评价——口味 50%、服务 30%、性价比 20% 合成总分。排名不符合预期时,调的是代码里的权重,不用动模型。
坦白说,这一节我本来也做好了实测代码,但正要运行时,Jev 的免费体验窗口恰好关闭(上线推广期约两周后转为付费模型),Score 实验停在了起跑线。以上用法来自官方文档,代码已验证格式无误,充值后即可运行。
它能用在哪里?
从官方文档和 cookbook 看,这套"判断原语"的适用面相当宽:
- 路由与分类:表单/工单/意图路由,分层级分类(专利、商品、代码库)
- 安全与审核:LLM 应用的输入输出 guardrail,一道请求完成多维度风险判定
- RAG 质量:检索结果相关性打分、重排序、引用真实性核对
- 数据工程:日期/邮箱/金额抽取后的候选确认,结构化数据提取的低成本校验级联
共同逻辑都是:让代码掌握系统控制权,模型只做窄而结构化的判断。
写在最后
Jev 打动我的不是某个单点能力,而是它背后的设计哲学——System One(快思考):不是所有问题都值得启动深度推理,软件里大量决策要的是校准过的概率、机器可读的置信度、毫秒级的响应。把"判断"从"生成"里剥离出来做成专用模型,这个分工思路本身就很值得关注。
这个思路对我手头的工作有直接意义。最近我在做一个智能体(Agent)项目,智能体每一步都要做大量轻量决策:识别用户意图、判断该调用哪个工具、评估中间结果是否达标——这些恰恰是"快思考"场景。如果每个判断都交给主模型慢吞吞地推理,延迟和成本都会失控。引入 Jev 这样的评估模型,可以把这些判断从主模型剥离出来,提高智能体的决策效率、降低成本,让主模型专注在真正需要慢思考的任务上。当然,在实际使用中我会坚持隐私安全、数据不出境的原则,只用非敏感数据跑判断链路。
如果你也在做路由、审核、RAG 这类"判断密集型"系统,建议去翻翻它的官方文档(docs.typesafe.ai),尤其是置信度门控路由和组合评分两个模式——即使不用 Jev,这套方法论也能平移到其他模型上。